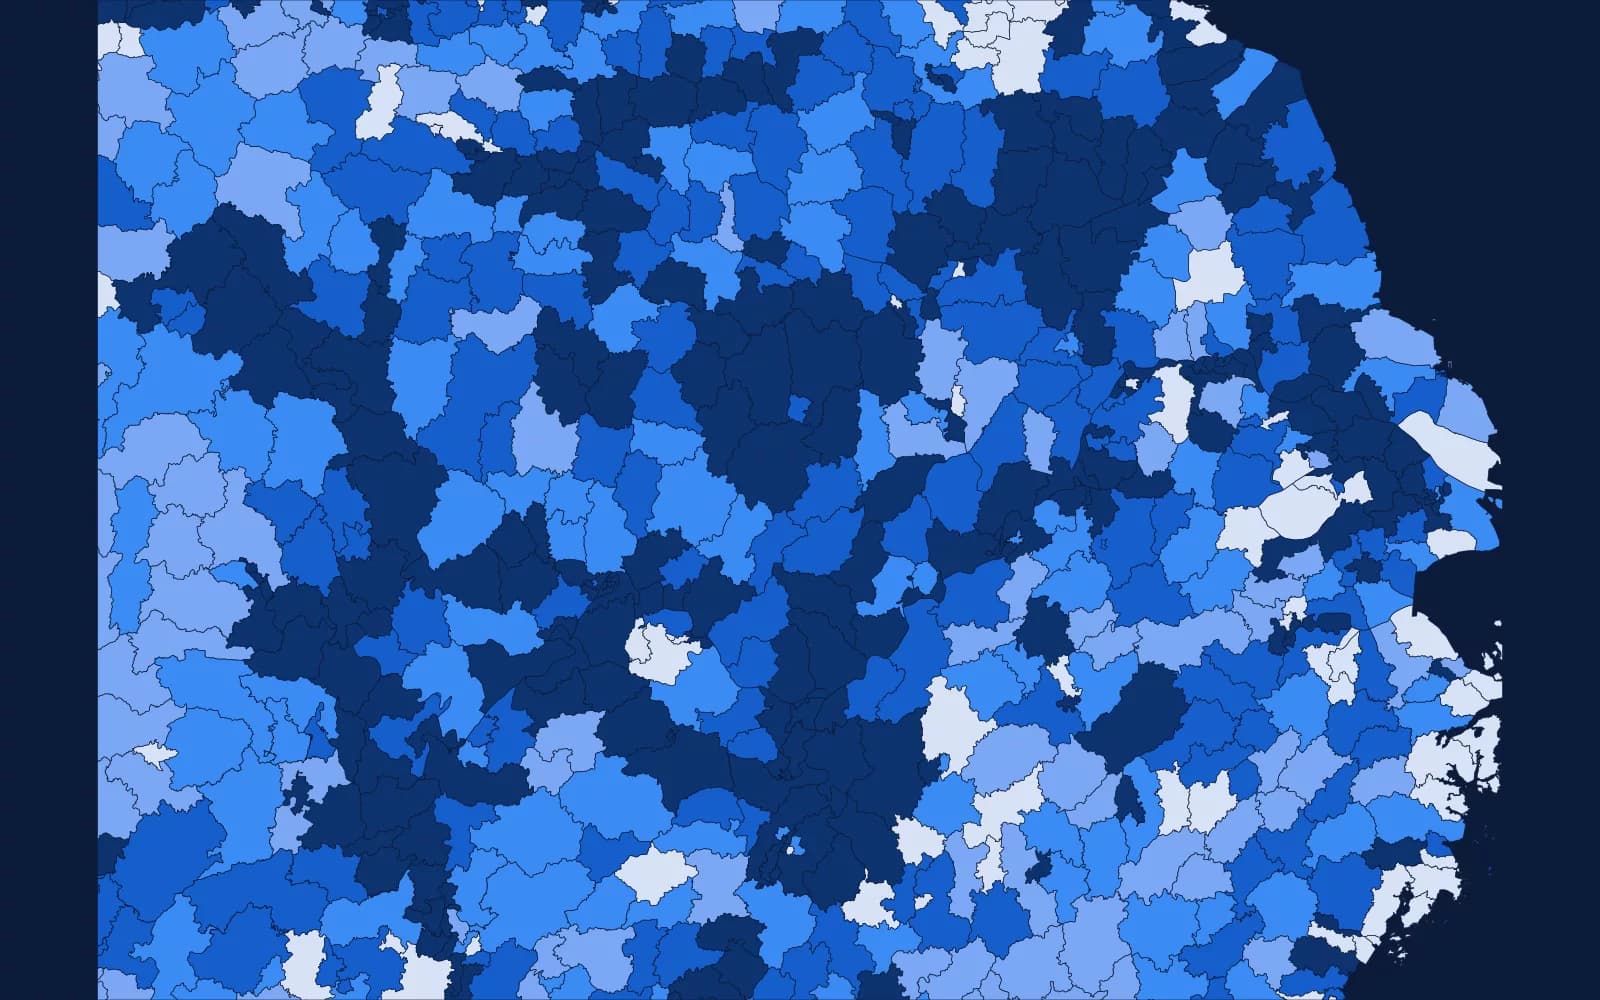
自然灾害空间数据,按区县画在县界上县级河流水系密度
county-river-network
一行是一个县区的河流水系统计。包含县的面积,河流、溪流、运河、沟渠的长度和密度,湖泊水库、河道水面、湿地、冰川的面积和水面比例,以及 1 到 5 级主要河流的长度和密度。覆盖全国的县区,按 2021 年的行政区划,由开放街道地图的水系和全国 1 到 5 级河流按县界切分统计,不随年份变化。用来比较各县的水网疏密和临水程度,估计洪涝和内涝的暴露,补上地级市河流密度在县一级的空白。
共 312 个数据集
工程项目(取消这个条件)交通运输(取消这个条件)医疗药械(取消这个条件)自然灾害(取消这个条件)区域底数(取消这个条件)司法监管(取消这个条件)有 AI 扩增字段(取消这个条件)全部清除
自然灾害空间数据,按区县画在县界上county-river-network
一行是一个县区的河流水系统计。包含县的面积,河流、溪流、运河、沟渠的长度和密度,湖泊水库、河道水面、湿地、冰川的面积和水面比例,以及 1 到 5 级主要河流的长度和密度。覆盖全国的县区,按 2021 年的行政区划,由开放街道地图的水系和全国 1 到 5 级河流按县界切分统计,不随年份变化。用来比较各县的水网疏密和临水程度,估计洪涝和内涝的暴露,补上地级市河流密度在县一级的空白。
自然灾害空间数据,按区县画在县界上county-terrain-stats
一行是一个县区的地形统计。包含平均、最低、最高海拔和海拔的 90% 分位数、高差、海拔的标准差,平均坡度,坡度大于 15 度和 25 度的面积比例。覆盖全国的县区,按 2021 年的行政区划,由约 250 米的数字高程模型按县界统计,不随年份变化。用来判断一个县是平原、丘陵还是山地,估计滑坡、泥石流和山洪的风险,以及工程施工的难度。
自然灾害county-terrain-relief
一行是一个县区。包含行政区划代码、中文和英文名称、地形起伏度。覆盖全国的县区,数值由 1 千米栅格按行政区取平均得到,不随年份变化。用来判断一个地方是平原还是山地,估计滑坡、山洪等地质和洪涝风险,也用来估计工程施工的难度。
区域底数region-county-housing-price
一行是一个区县 2023 年的平均房价。覆盖全国 2852 个区县级单位。均价是 0 的 191 行表示没有数据。“统计量”的含义原表没有写,可能是样本数。可用来比较各地房价。
区域底数空间数据,地图上画成面county-boundary
一行是一个县级行政区的边界,包含区划代码、名称、所在城市和省、面积、中心点和外框。共 2850 行,覆盖全国的县级行政区。香港、澳门、台湾各是一行,没有分到县。边界取自公开的 2023 年初县级行政区划矢量图层,不是官方发布的边界,没有审图号,不能用来确定权属和界线。用来在地图上画出一个县的范围,按县汇总点和线,或者把县级统计数据画成分级的地图。
医疗药械county-hospital-travel-time
一行是一个区县:县内各人口网格到最近的一级、二级、三级医院的驾车时间(分钟)的最小值、平均值、中位数、四分位数、最大值和标准差,以及参与计算的网格数和人口。覆盖全国 2844 个县级单位(不含港澳台和东莞、中山、儋州、嘉峪关这类不设区县的地级市),按 2023 年区划。是按路网和医院位置模型算出来的。可用来看各县看病的远近,给健康险和意外险做参照。
区域底数dev-zone-profile
一行是一个国家级或省级开发区:名称、级别、类型(经开区、高新区、海关特殊监管区域、自贸试验区、省级开发区等)、所在省份、成立时间、核准面积(公顷)、主导产业和经纬度。截至 2022 年 6 月,共 2781 个。可用来看工业和仓储资产集中的地点,做企业财产险、工程险的风险暴露参照。
区域底数city-digital-economy-carbon
一行是一个地级市一年的二氧化碳排放量和数字经济水平。数字经济水平有熵值法和主成分法两种算法。覆盖约 290 个地级市,2011–2019 年,共 2612 行。原表里线性插值和回归填补的列没有收录,缺的年份就是空。和已上线的 city-digital-economy-pollution 的数字经济水平算法不同,数值不能混用。用来分析数字经济和碳排放的关系,给绿色金融和环境责任相关的区域分析做参考。
区域底数city-digital-economy-indicators
一行代表一个城市在特定年份的数字经济相关统计指标。覆盖中国主要城市,包含GDP、人口、互联网用户、电信业务量等基础数据。可用于构建城市数字经济发展指数,评估区域信息化水平。
区域底数city-digital-economy-raw
一行代表一个地级市在特定年份的数字经济基础指标。覆盖全国地级市及直辖市,包含电信收入、IT从业人员、宽带及移动用户数等核心数据。可用于构建区域数字化发展水平指标,辅助区域风险建模。
区域底数region-dialect-classification
一行代表一个行政区划单位,包含其所属的方言区、方言片及方言小片等语言学分类信息。数据覆盖全国31个省市的2300多个区县。在保险业务中,可用于分析特定方言区域的文化特征、客户沟通偏好或作为区域社会属性的辅助标签。
区域底数region-city-income-gap
一行是一个城市一年的城乡收入差距泰尔指数,以及计算用到的城镇和农村居民人均可支配收入、城镇化率、总人口和城乡人口。覆盖 209 个地级及以上城市(含直辖市),2010 年到 2019 年,共 2090 行。可用来比较各城市城乡收入差距的大小和变化。原表有 72 行的泰尔指数和同一行的收入、人口算出来的对不上(集中在山东几个城市 2010-2012 年,还有一个负值),这些行的泰尔指数留空。